
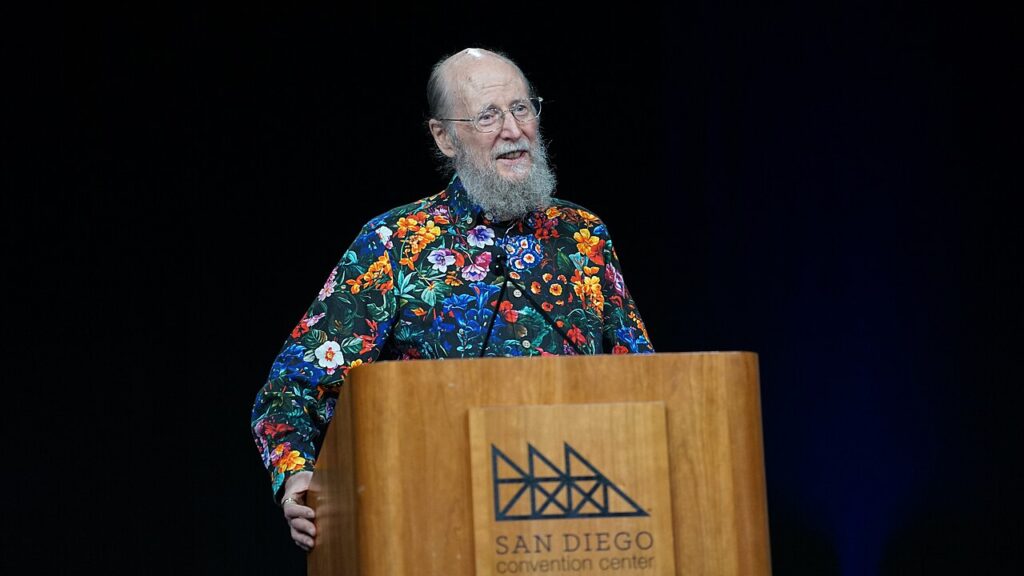
Richard Sutton, uno de los fundadores del aprendizaje por refuerzo y ganador del premio Turing, publicó el 7 de noviembre un mensaje breve en X que reabrió una discusión de fondo de la inteligencia artificial. Sostuvo que el cómputo por fuerza bruta no basta para alcanzar la inteligencia, que hacen falta métodos nuevos y que la investigación todavía tiene mucho por resolver. The Decoder interpretó el mensaje como una advertencia a quienes creen que basta con agrandar los modelos de lenguaje para llegar a una inteligencia general.
La frase llamó la atención por quién la escribió. Sutton es el autor de «La lección amarga», un ensayo de marzo de 2019 publicado en su sitio personal, incompleteideas.net, que se convirtió en una referencia obligada en la industria. Su tesis central era que la mayor lección de 70 años de investigación en IA es que los métodos generales que aprovechan la computación terminan siendo los más efectivos, y por amplio margen. Usaba como ejemplos el ajedrez, donde la búsqueda masiva derrotó a Kaspárov en 1997, y el Go, donde los esfuerzos por codificar conocimiento humano resultaron irrelevantes una vez que la búsqueda se aplicó a escala.
Con los años, ese texto fue citado como respaldo de la estrategia de escalar: más datos, más chips y modelos más grandes. Pero una lectura atenta muestra que Sutton nunca defendió una arquitectura en particular. En el ensayo identifica dos métodos que parecen escalar sin límite, la búsqueda y el aprendizaje, y propone construir solo los «metamétodos» capaces de descubrir la complejidad del mundo por sí mismos, en lugar de incorporar a mano lo que los investigadores creen saber. Su crítica actual a los modelos de lenguaje es coherente con esa idea, no una contradicción.
Sutton lleva tiempo explicando por qué no cree que los modelos de lenguaje actuales sean el camino. En una entrevista de septiembre de 2025 en el Dwarkesh Podcast, sostuvo que estos sistemas modelan lo que una persona diría, no cómo responderá el mundo a una acción, y que por eso no tienen un verdadero modelo del mundo. «Para mí, tener un objetivo es la esencia de la inteligencia», dijo entonces, y agregó que predecir la siguiente palabra no cuenta como un objetivo que cambie algo en el mundo. Para él, el aprendizaje real ocurre al actuar, observar las consecuencias y ajustar, de manera continua.
Según The Decoder, Sutton ha dicho además que usar datos sintéticos es un «gran error», porque cualquier simulación del mundo real, que es infinitamente complejo, resulta «microscópica». Su apuesta son agentes con modelos del mundo que sigan aprendiendo de su propia experiencia después del entrenamiento, sin borrar lo que ya sabían. En su crítica, Sutton sostiene que los modelos de lenguaje no siguen aprendiendo de manera continua durante su uso, una capacidad que considera necesaria.
Esa apuesta ya tiene forma de empresa. En julio, The Decoder informó que Sutton fundó Oak Lab en Toronto junto a Khurram Javed, ambos con paso previo por Keen Technologies, la compañía de IA de John Carmack. El objetivo declarado es construir agentes que aprendan de forma continua de su entorno y, a largo plazo, un sistema de un billón de parámetros que aprenda y planifique en tiempo real con 20 vatios de energía.
La reacción al mensaje mostró que el debate sigue abierto. The Decoder recogió la opinión de Jerry Tworek, exinvestigador de OpenAI, quien cree que la lección amarga sigue vigente, pero que mientras más cómputo se invierte en entrenar, más importa el algoritmo, porque algunos escalan y otros chocan con un muro. El investigador Jayden Teoh, citado por el mismo medio, sostuvo que ha visto en repetidas ocasiones cómo una mala lectura del ensayo frena la investigación académica, y que una idea no necesita sobrevivir al escalamiento para siempre para haber sido un aporte valioso.
Del otro lado están los líderes de las empresas que más invierten en escalar. Según The Decoder, Sam Altman, director ejecutivo de OpenAI, afirma que el escalamiento de los modelos de lenguaje está lejos de agotarse, y Dario Amodei, de Anthropic, lo describió como «un arcoíris sin final». El propio medio advierte que ambos son parte interesada, porque el negocio de sus compañías depende de esa apuesta.
La discusión tampoco es nueva. Días después del ensayo de 2019, el robotista Rodney Brooks publicó en su blog «Una lección mejor», donde argumentó que la conclusión correcta no era que más cómputo siempre gana, sino que hay que considerar el costo total de cada solución, incluido el ingenio humano que todavía exige y su huella de carbono.
Para quien sigue la industria, el mensaje de Sutton no prueba que el escalamiento haya tocado techo: es una opinión, aunque de alguien con peso propio. Lo que sí deja claro es que la promesa de una inteligencia general basada solo en agrandar los modelos actuales es una apuesta, no un hecho demostrado, y que parte de la investigación de punta ya se está moviendo hacia sistemas que aprendan de la experiencia.